Die Monetarisierung von Data Science 2016 ist eine internationale Konferenz, die tiefere Einblicke in die geschäftliche Anwendung von Data Science bietet und vor allem beantwortet, wie die riesigen Datenmengen, die Unternehmen täglich besitzen und sammeln, monetarisiert werden können.
Die Konferenz, die am 13. und 14. April 2016 im Hypo Center in Zagreb stattfindet, versammelt mehr als 40 ausländische und inländische Experten, die anhand praktischer Beispiele dem Geschäftspublikum die Anwendung von Data Science in ihren Betrieben präsentieren.
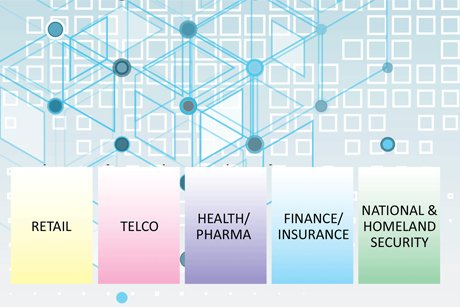
Das Konferenzprogramm, organisiert von IN2Data und Eventa01, umfasst hauptsächlich fünf Geschäftsbereiche: Telekommunikation, Handel, Finanzindustrie, Gesundheitswesen und Pharmaindustrie sowie nationale Sicherheit. Der erste Tag der Konferenz ist auf das Geschäftspublikum zugeschnitten, wo die Teilnehmer anhand konkreter Beispiele lernen, wie sie Data Science für das Datenmanagement und die Entscheidungsfindung in wichtigen Geschäftsfragen nutzen können. Der zweite Tag richtet sich an ein Fachpublikum und Personen, die tiefere Einblicke in die Methoden und Werkzeuge gewinnen möchten, die in Organisationen im Bereich Data Science verwendet werden.
Unter anderem gehören einige der ausländischen Referenten auf der Konferenz: Jiri Materna, CGI; Michael Kowalski, Lab4motion; Mark Torr, Microsoft; George Zikry, HP; Miha Senčar, Tenzor; und Boro Nikić, Statistisches Amt von Slowenien. Von inländischen Experten sind auf der Konferenz vertreten: Dragan Primorac, Universität Split; Robert Kopal, IN2 Data; Kruno Hrvatinić, Rimac Automobili; Dražen Oreščanin, Business Intelligence; Mile Šikić, FER; Benjamin Cerovac, BisNode; Vladimir Nedović, Flavourspace; Goran Klepac, RBA; Damir Čičak, CRH; Krešimir Đuračić, IN2trace; Hrvoje Šimić, CROZ; und viele andere.
Nachdem das Harvard Business Review den Beruf des Data Scientist zum attraktivsten Job des 21. Jahrhunderts erklärt hat, ist das Interesse an diesem Bereich gestiegen. Nicht ohne Grund, da die Nachfrage nach Personen, die Bedeutung aus großen Datenmengen extrahieren und verstehen können, wie man sie effektiv nutzt und einsetzt, ständig wächst.